Referencia
- Blázquez-Ochando, M., Prieto-Gutierrez, J. J., & Ovalle-Perandones, M. A. (2026). Prompt engineering for library agents: development of an AI-based conversational reading recommendation system. Library Hi Tech, 1-18. https://doi.org/10.1108/LHT-08-2025-0196 | Código fuente del sistema (licencia MIT): https://github.com/manublaz/laiabot
Comentario
El servicio de referencia y orientación lectora es una de las funciones más genuinamente bibliotecarias: escuchar una necesidad informativa, a menudo formulada de manera vaga, y traducirla en lecturas pertinentes de la colección. Es también uno de los servicios más expuestos a las limitaciones estructurales de muchas bibliotecas: plantillas reducidas, horarios acotados y una presión asistencial que deja poco margen para la conversación pausada que exige una buena recomendación.
La irrupción de los grandes modelos de lenguaje parece ofrecer una salida inmediata, pero los asistentes genéricos presentan un problema de fondo para una biblioteca: no conocen su colección. Pueden recomendar títulos que la institución no posee, describir obras con imprecisión o incluso inventar referencias, y no dejan ninguna huella estructurada de la interacción que la biblioteca pueda analizar después. Además, operan al margen de los principios profesionales que orientan la mediación lectora, como la neutralidad, la inclusión o el acceso equitativo al conocimiento.
El artículo parte de una tesis que conviene subrayar: la calidad de un agente bibliotecario no depende solo del modelo de lenguaje, sino sobre todo del diseño del prompt que lo gobierna. Decidir qué variables del lector importan, qué filtros aplicar, cómo anclar la respuesta a la colección real y qué datos devolver a la institución es una tarea que exige conocimiento biblioteconómico, no solo destreza técnica. La ingeniería del prompt se convierte así en una competencia propia de la Documentación.
Propósito de la investigación
El artículo presenta el diseño, desarrollo e implementación de LaIABot, un agente de inteligencia artificial basado en prompting estructurado para la recomendación bibliográfica en entornos bibliotecarios. Su objetivo es ampliar la disponibilidad y la personalización del servicio de orientación lectora sin exigir una inversión significativa, como respuesta a la escasez de personal y a las limitaciones de tiempo que afectan a muchas bibliotecas.
La innovación principal reside en el diseño de prompts que generan dos salidas simultáneas. La primera se dirige al usuario, con recomendaciones claras y contextualizadas. La segunda se dirige a la institución, en formato JSON, con los metadatos de la interacción, lo que permite retroalimentar el sistema, integrarlo en el SIGB y enriquecer los procesos de análisis y gestión documental.
El trabajo adopta un enfoque centrado en el usuario y fundamentado en los principios de la Biblioteconomía y en criterios éticos. El sistema se publica como software libre, con una arquitectura modular pensada para su réplica en bibliotecas públicas, académicas y especializadas. El estudio se centra en la mediación lectora y la recomendación personalizada; la implantación en servicio real y los estudios de usabilidad quedan planteados como fases posteriores.
Marco conceptual: el prompt como instrumento documental
En los modelos de lenguaje, el prompt se define como el conjunto de instrucciones, pautas, ejemplos y parámetros que guían la generación de respuestas. Funciona como un marco comunicativo y funcional que determina el propósito de la interacción, el rol asumido, el formato de salida, las restricciones temáticas y el tratamiento de la información (Brown et al., 2020; Liu et al., 2023).
La ingeniería del prompt se ha consolidado como una disciplina dentro del procesamiento del lenguaje natural, orientada a desarrollar prompts sistemáticos que optimicen la pertinencia, la precisión y la utilidad de las respuestas (Reynolds y McDonell, 2021). Combina aportaciones de la lingüística aplicada, el diseño instruccional y la semiótica computacional, y descansa en principios como la formulación precisa de las instrucciones, la optimización iterativa a partir de los resultados y la adaptación al dominio y al público destinatario.
Trasladado a la biblioteca, el prompt deja de ser una mera instrucción técnica y pasa a ser la codificación explícita de un saber profesional. La literatura sobre sistemas de recomendación en bibliotecas (Beel et al., 2016; Ricci et al., 2022) subraya la importancia de modelar tanto el perfil del usuario como el contexto organizativo. En un agente conversacional, ese modelado ocurre precisamente en el prompt: el agente sabe del lector, de la colección y del servicio exactamente lo que el prompt le enseña.
Diseño del prompt base: cinco módulos configurables
LaIABot se construye sobre un prompt base configurable, organizado en cinco módulos que cada biblioteca puede parametrizar según su contexto:
- Perfil de usuario. Recoge las variables que condicionan la pertinencia de una recomendación: edad y nivel lector, géneros preferidos e historial de lectura (integrable mediante el SIGB o el OPAC), contexto y propósito de la consulta (recreativo, educativo, profesional o investigador), preferencias de formato y necesidades de accesibilidad, estado emocional y necesidades del momento, tono conversacional y número de recomendaciones deseado.
- Filtrado de sugerencias. Establece los criterios con los que se seleccionan y depuran las propuestas: adecuación al perfil del lector, pertinencia temática y diversidad autoral y temática.
- Tipología de la colección. Describe al agente la naturaleza de los fondos disponibles, para que las recomendaciones se mantengan dentro de lo que la biblioteca puede ofrecer realmente.
- Servicios de la biblioteca. Incorpora la información institucional (horarios, préstamo, actividades) que permite atender consultas de servicio y conectar la recomendación con el uso efectivo de la biblioteca.
- Mecanismos de retroalimentación. Define la salida estructurada destinada a la institución y las vías por las que cada interacción alimenta la mejora del servicio.
La consecuencia práctica de este diseño es que el comportamiento del agente no está fijado en el código. Los prompts se almacenan en la base de datos, organizados por modo y tipo (evaluación, base, sugerencia, seguimiento, límites), y se editan desde el panel de administración. Una biblioteca puede adaptar LaIABot a su público y a su colección sin reprogramarlo.
Arquitectura del sistema y salida dual
La arquitectura técnica combina Python y Flask en el servidor, tecnologías web estándar (HTML5, CSS3 y JavaScript) en la interfaz y SQLite con su extensión de búsqueda de texto completo FTS5 como gestor de datos. El procesamiento del lenguaje se apoya en un modelo Llama 3 de 8.000 millones de parámetros servido a través de la API de Groq, aunque el sistema es agnóstico respecto al modelo: puede conectarse a LM Studio o a cualquier LLM accesible mediante una API REST estándar.
Los datos se reparten en tres bases: el catálogo bibliográfico con su índice FTS5, el sistema conversacional (hilos, mensajes, usuarios y prompts) y la información de servicios y actividades de la biblioteca, también indexada a texto completo.
Tres modos de funcionamiento. Cada mensaje del usuario pasa primero por un prompt de evaluación que lo clasifica en uno de tres modos: recomendación de libros (modo 1), información sobre servicios de la biblioteca (modo 2) o conversación general acotada por un prompt de límites que reconduce hacia temas bibliotecarios (modo 3). La clasificación se repite en cada turno, de modo que el lector puede pasar de pedir una novela a preguntar por el horario sin reiniciar la conversación. Si la API no responde, una heurística basada en palabras clave mantiene el servicio en funcionamiento.
La salida dual. En el modo de recomendación, el prompt base obliga al modelo a responder con un JSON de dos campos:
El campo user_response llega directamente al canal conversacional. El campo system_keywords no lo ve el lector: se transforma en una consulta FTS5 contra el catálogo, con una búsqueda LIKE como respaldo. Los registros recuperados se formatean como referencias APA y un segundo prompt genera un breve comentario para cada título.
El resultado es que los títulos recomendados no los genera el modelo, sino el catálogo; el modelo se limita a interpretar la petición y a comentar los resultados. Cada turno queda además registrado con sus metadatos (categoría de la consulta, palabras clave, autores recomendados y fecha), que constituyen la vertiente institucional de la salida dual.
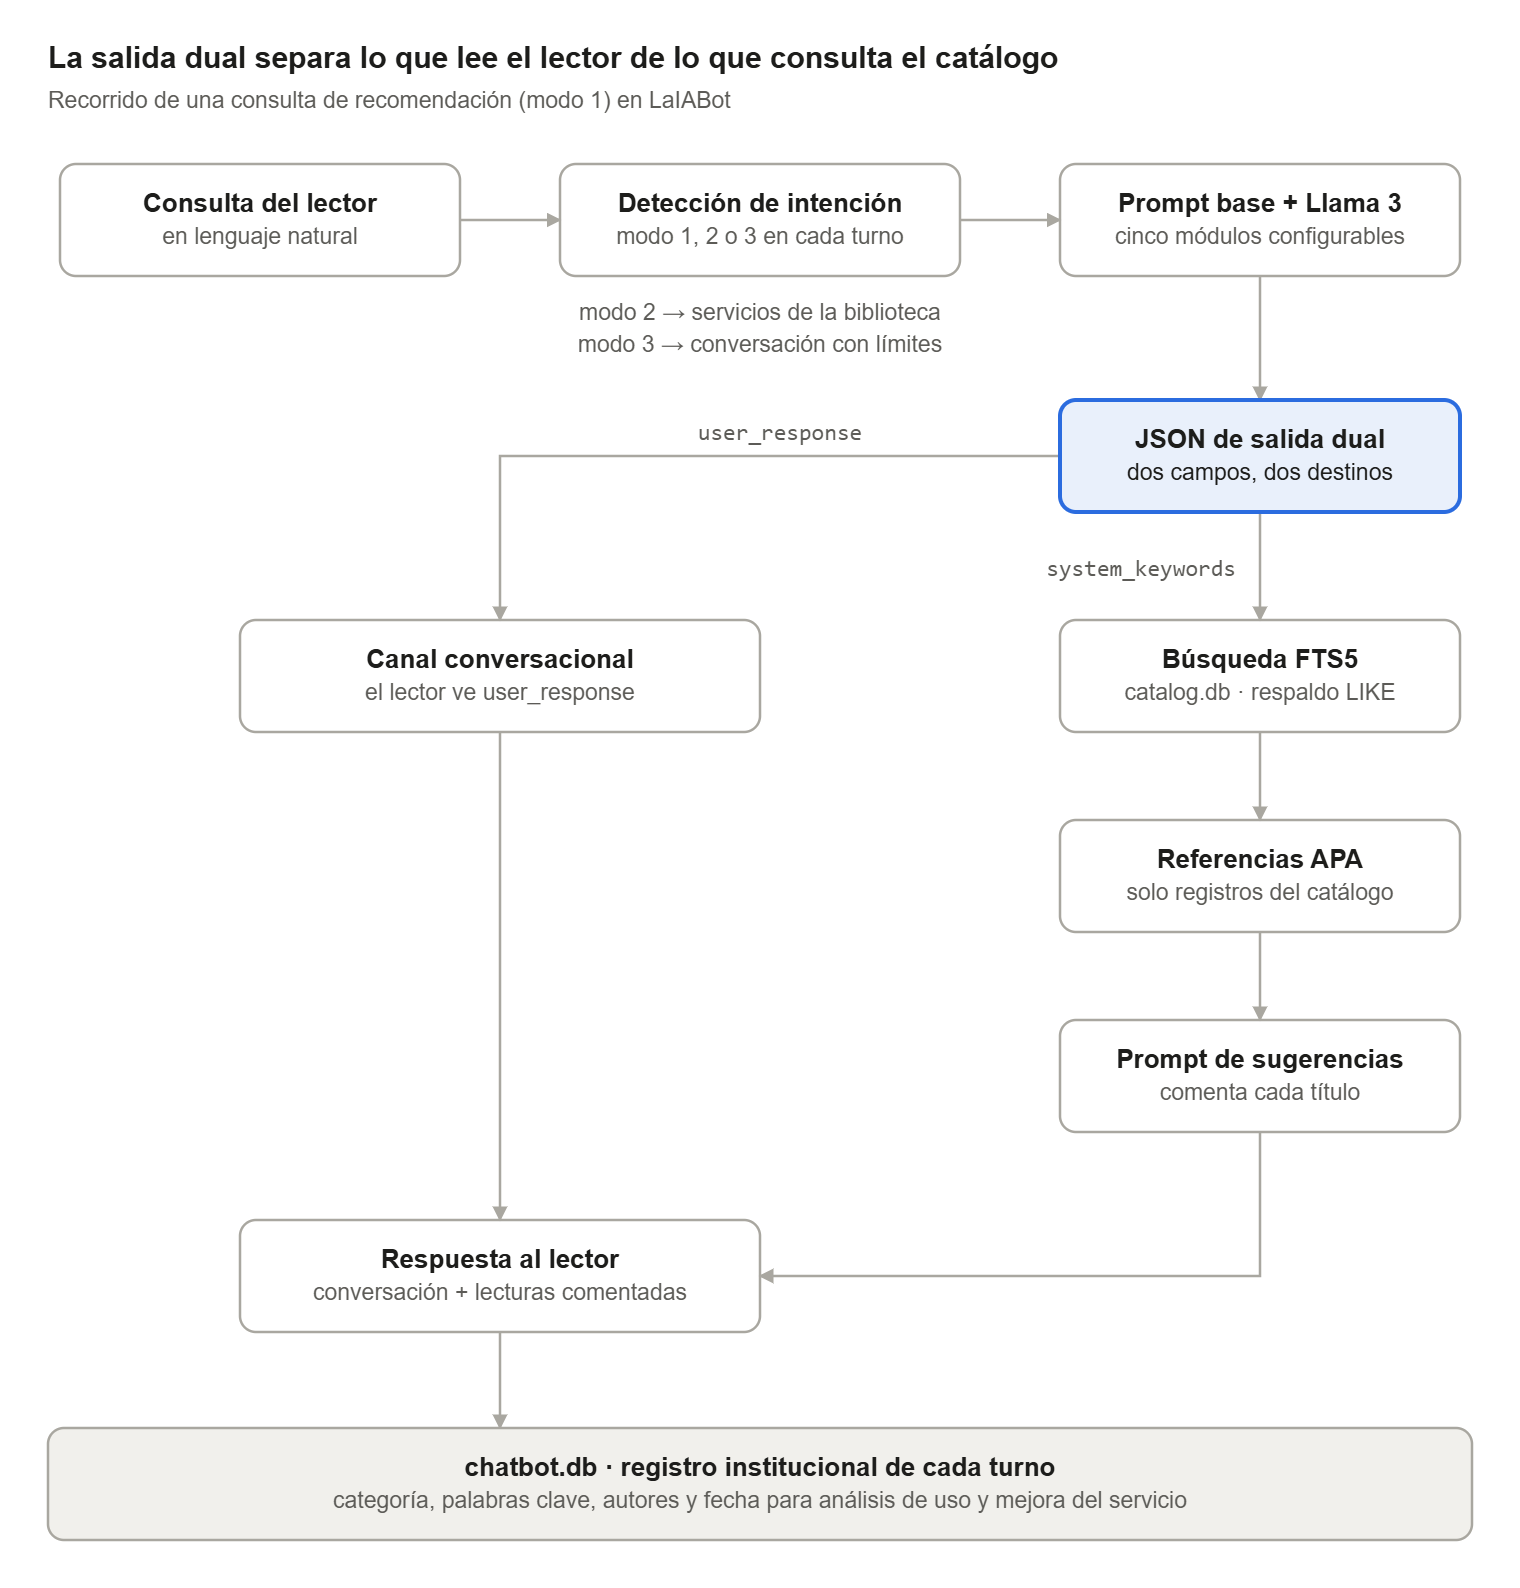
Fig1. Esquema del flujo de trabajo del agente de recomendación de lecturas para OPAC de bibliotecas LaIABot
El lector solo ve user_response; system_keywords interroga al catálogo, de modo que los títulos recomendados proceden siempre de la colección real.
Metodología de evaluación: corpus y consultas de prueba
- Corpus bibliográfico. Para validar el prototipo en un entorno controlado se construyó un corpus de aproximadamente 8.500 registros extraídos de Project Gutenberg mediante un script de web scraping disponible en el repositorio. La elección responde a tres razones: su acceso abierto elimina barreras institucionales y garantiza la reproducibilidad; su estructura de metadatos emula elementos esenciales de MARC21; y su amplitud cronológica (siglos XVI a XX) reproduce la heterogeneidad temporal de las colecciones académicas y patrimoniales.
- Tamaño representativo. La cifra de 8.500 registros se eligió deliberadamente para reflejar el orden de magnitud de una biblioteca pública o local pequeña o mediana, el contexto de despliegue más probable para una herramienta de código abierto y bajo coste.
- Conjunto de consultas. Se elaboraron 150 consultas sintéticas en lenguaje natural, distribuidas en tres categorías equilibradas de 50: académicas (peticiones especializadas orientadas a la investigación), recreativas (lectura general y de ocio) y complejas (peticiones multicriterio que combinan restricciones temporales, temáticas y formales).
- Criterios de construcción. Las consultas siguen la taxonomía de transacciones de referencia de la RUSA (2008) y seis criterios explícitos declarados en los metadatos del propio conjunto: diversidad terminológica, variación de complejidad, cobertura de periodos históricos, amplitud disciplinar, patrones de lenguaje natural e inclusión deliberada de casos límite. Cada consulta incluye los temas esperados, lo que permite validar la extracción de palabras clave.
- Ejecución automatizada. Un script de evaluación lanzó la batería completa y registró métricas de estabilidad técnica, consistencia de la salida JSON, recuperación, diversidad y tiempos de respuesta. Tanto el conjunto de consultas como los resultados detallados están publicados en el repositorio, de modo que cualquier investigador puede reproducir la prueba.
Resultados
Los datos de la prueba piloto parecen indicar que la arquitectura es técnicamente viable y estable en un entorno controlado.
- Estabilidad del sistema. Las 150 consultas se completaron sin errores críticos (100%). Solo se registró un fallo puntual de la API, absorbido por los mecanismos de respaldo.
- Consistencia estructural. El 99,33% de las respuestas (149 de 150) devolvió un JSON válido. Este dato sugiere que el prompting estructurado basta para que un modelo de 8.000 millones de parámetros respete de forma casi sistemática el formato de salida exigido, condición imprescindible para que la salida dual funcione.
- Recuperación efectiva. El 96,67% de las consultas (145 de 150) recuperó registros del catálogo mediante FTS5, con una media de 4,8 libros por consulta y 720 recomendaciones en total.
- Diversidad autoral. Las 720 recomendaciones correspondieron a 493 autores distintos, una proporción del 68,5% que apunta a una distribución amplia, poco concentrada en un canon reducido de nombres.
- Calidad de la interacción. Las respuestas conversacionales tuvieron una extensión media de 323 caracteres, breves pero informativas, y el modelo extrajo una media de 4,6 palabras clave por consulta para interrogar al catálogo.
- Tiempos de respuesta. El tiempo medio fue de 3,9 segundos por consulta, con unas dos llamadas al modelo por petición (295 en total), un rendimiento adecuado para un servicio conversacional y con margen de optimización.
Discusión
La salida dual como aportación central. Una misma interacción produce dos productos con destinatarios distintos. Para el lector, una conversación natural con lecturas comentadas; para la biblioteca, un registro estructurado que puede integrarse en el SIGB, explotarse estadísticamente o servir para enriquecer el catálogo. Las consultas que no obtienen resultados, por ejemplo, pueden leerse como indicios de demanda no cubierta por la colección.
El catálogo como ancla de la recomendación. Al separar la interpretación de la petición, que corresponde al modelo, de la selección de títulos, que corresponde al catálogo, LaIABot reduce el riesgo de recomendar obras inexistentes o ajenas a la colección. Además, la búsqueda sobre todo el fondo favorece la visibilidad de colecciones históricas y autores menos conocidos, lo que refuerza el papel social y educativo de la biblioteca.
Escalabilidad e integración. FTS5 dota a SQLite de una capacidad de indexación a texto completo equivalente a la de los grandes gestores de bases de datos y las plataformas SIGB comerciales, adecuada para catálogos pequeños y medianos. Para colecciones de cientos de miles o millones de registros, el sistema debería migrar a motores como PostgreSQL, Elasticsearch o Solr y conectarse al SIGB institucional mediante API, por ejemplo con Koha o Evergreen. La arquitectura de prompts y la lógica de procesamiento, que constituyen la aportación metodológica, permanecerían intactas.
Ética y gobernanza de datos. Las recomendaciones pueden reproducir sesgos procedentes de los datos de entrenamiento o del propio diseño del prompt. Por ello, el artículo insiste en realizar auditorías periódicas sobre la representación de autoría, géneros y perspectivas culturales, y en establecer protocolos de gobernanza que garanticen neutralidad, inclusión, transparencia y privacidad, especialmente porque la salida institucional genera metadatos sobre las interacciones de los usuarios.
Limitaciones. La validación se ha realizado en un entorno controlado, con consultas sintéticas y un corpus de dominio público. Los estudios de implantación y de usabilidad con lectores reales constituyen las siguientes fases de la investigación, para las que este trabajo sienta las bases metodológicas y tecnológicas.
Conclusiones
LaIABot muestra que es posible construir un agente de orientación lectora útil, abierto y de bajo coste cuando el esfuerzo se concentra en el diseño del prompt y no solo en la elección del modelo. Su disponibilidad permanente, la personalización según el perfil del lector y su capacidad de integración con los sistemas existentes lo convierten en un complemento viable del servicio de referencia, especialmente para bibliotecas con recursos limitados.
La conclusión de fondo es que el agente no sustituye la mediación profesional, sino que la prolonga. Los criterios que lo gobiernan (quién es el lector, qué colección tiene la biblioteca, qué principios guían la selección y qué datos necesita la institución) son conocimiento biblioteconómico codificado en lenguaje natural. Por eso la ingeniería del prompt debe entenderse como una competencia del profesional de la información, y su desarrollo como un campo legítimo de investigación en Biblioteconomía y Documentación.
LaIABot se ofrece, en definitiva, como una base metodológica abierta y adaptable, capaz de evolucionar con las necesidades de cada institución. Su valor no reside solo en las recomendaciones personalizadas, sino en los datos estructurados que devuelve a la biblioteca para conocer mejor a sus lectores y mejorar sus servicios.
Recursos
- Artículo en Library Hi Tech: https://doi.org/10.1108/LHT-08-2025-0196
- Código fuente de LaIABot (licencia MIT): https://github.com/manublaz/laiabot
- Conjunto de consultas y resultados de la evaluación: archivos
test_queries.json,test_results.jsonytest_metrics.jsondel repositorio.